Enhancing Vision-Audio Capability in Omnimodal LLMs with Self-KD
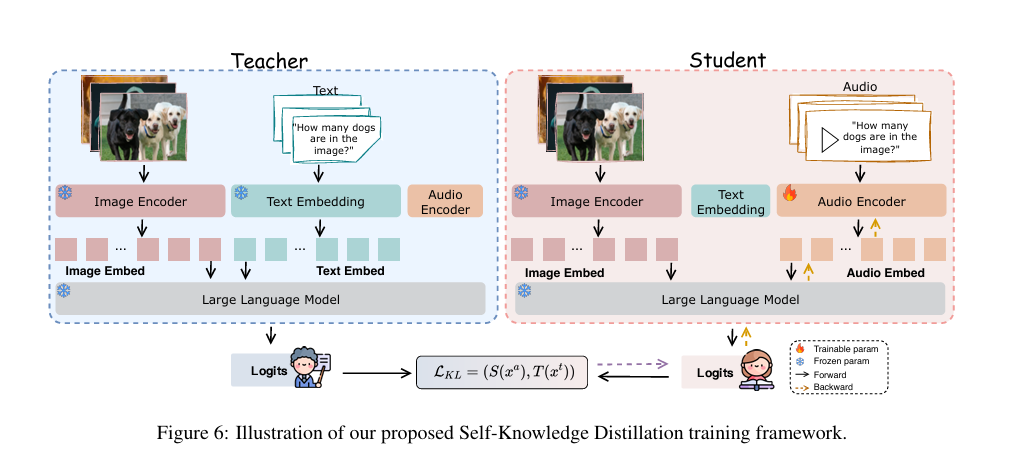
Omnimodal Large Language Models (OLLMs) like GPT-4o and Megrez have revolutionized how AI interacts with the world by seamlessly processing text, images, and audio. However, a critical performance gap persists: OLLMs perform significantly better with vision-text inputs than with vision-audio…
Enhancing Vision-Audio Capability in Omnimodal LLMs with Self-KD Read More »